Stellt man ChatGPT heute und morgen dieselbe Frage, bekommt man oft zwei verschiedene Antworten. Mal wird die eigene Marke genannt, mal nicht. Ist AI-Sichtbarkeit damit überhaupt messbar?
- Einzelne AI-Antworten sind tatsächlich Zufall
- Die Kernfrage: Wiederholen oder verbreitern?
- Warum Breite gewinnt
- Viele Prompts mitteln die Schwankung heraus
- Wann tägliche Abfragen trotzdem sinnvoll sind
- Präzise ist nicht gleich richtig
- Im eigenen Set: stabil für die eigene Marke, unsicher für Wettbewerber
- Was daraus folgt
Sie lässt sich verlässlich messen, nur anders, als viele Tools und Ratgeber es nahelegen. Wir haben 10.826 tägliche Messreihen aus SISTRIX-Daten ausgewertet, über vier AI-Modelle und acht Länder. Das Ergebnis ist eindeutig: Wer verlässliche Zahlen will, sollte nicht denselben Prompt immer wieder abfragen, sondern möglichst viele verschiedene.
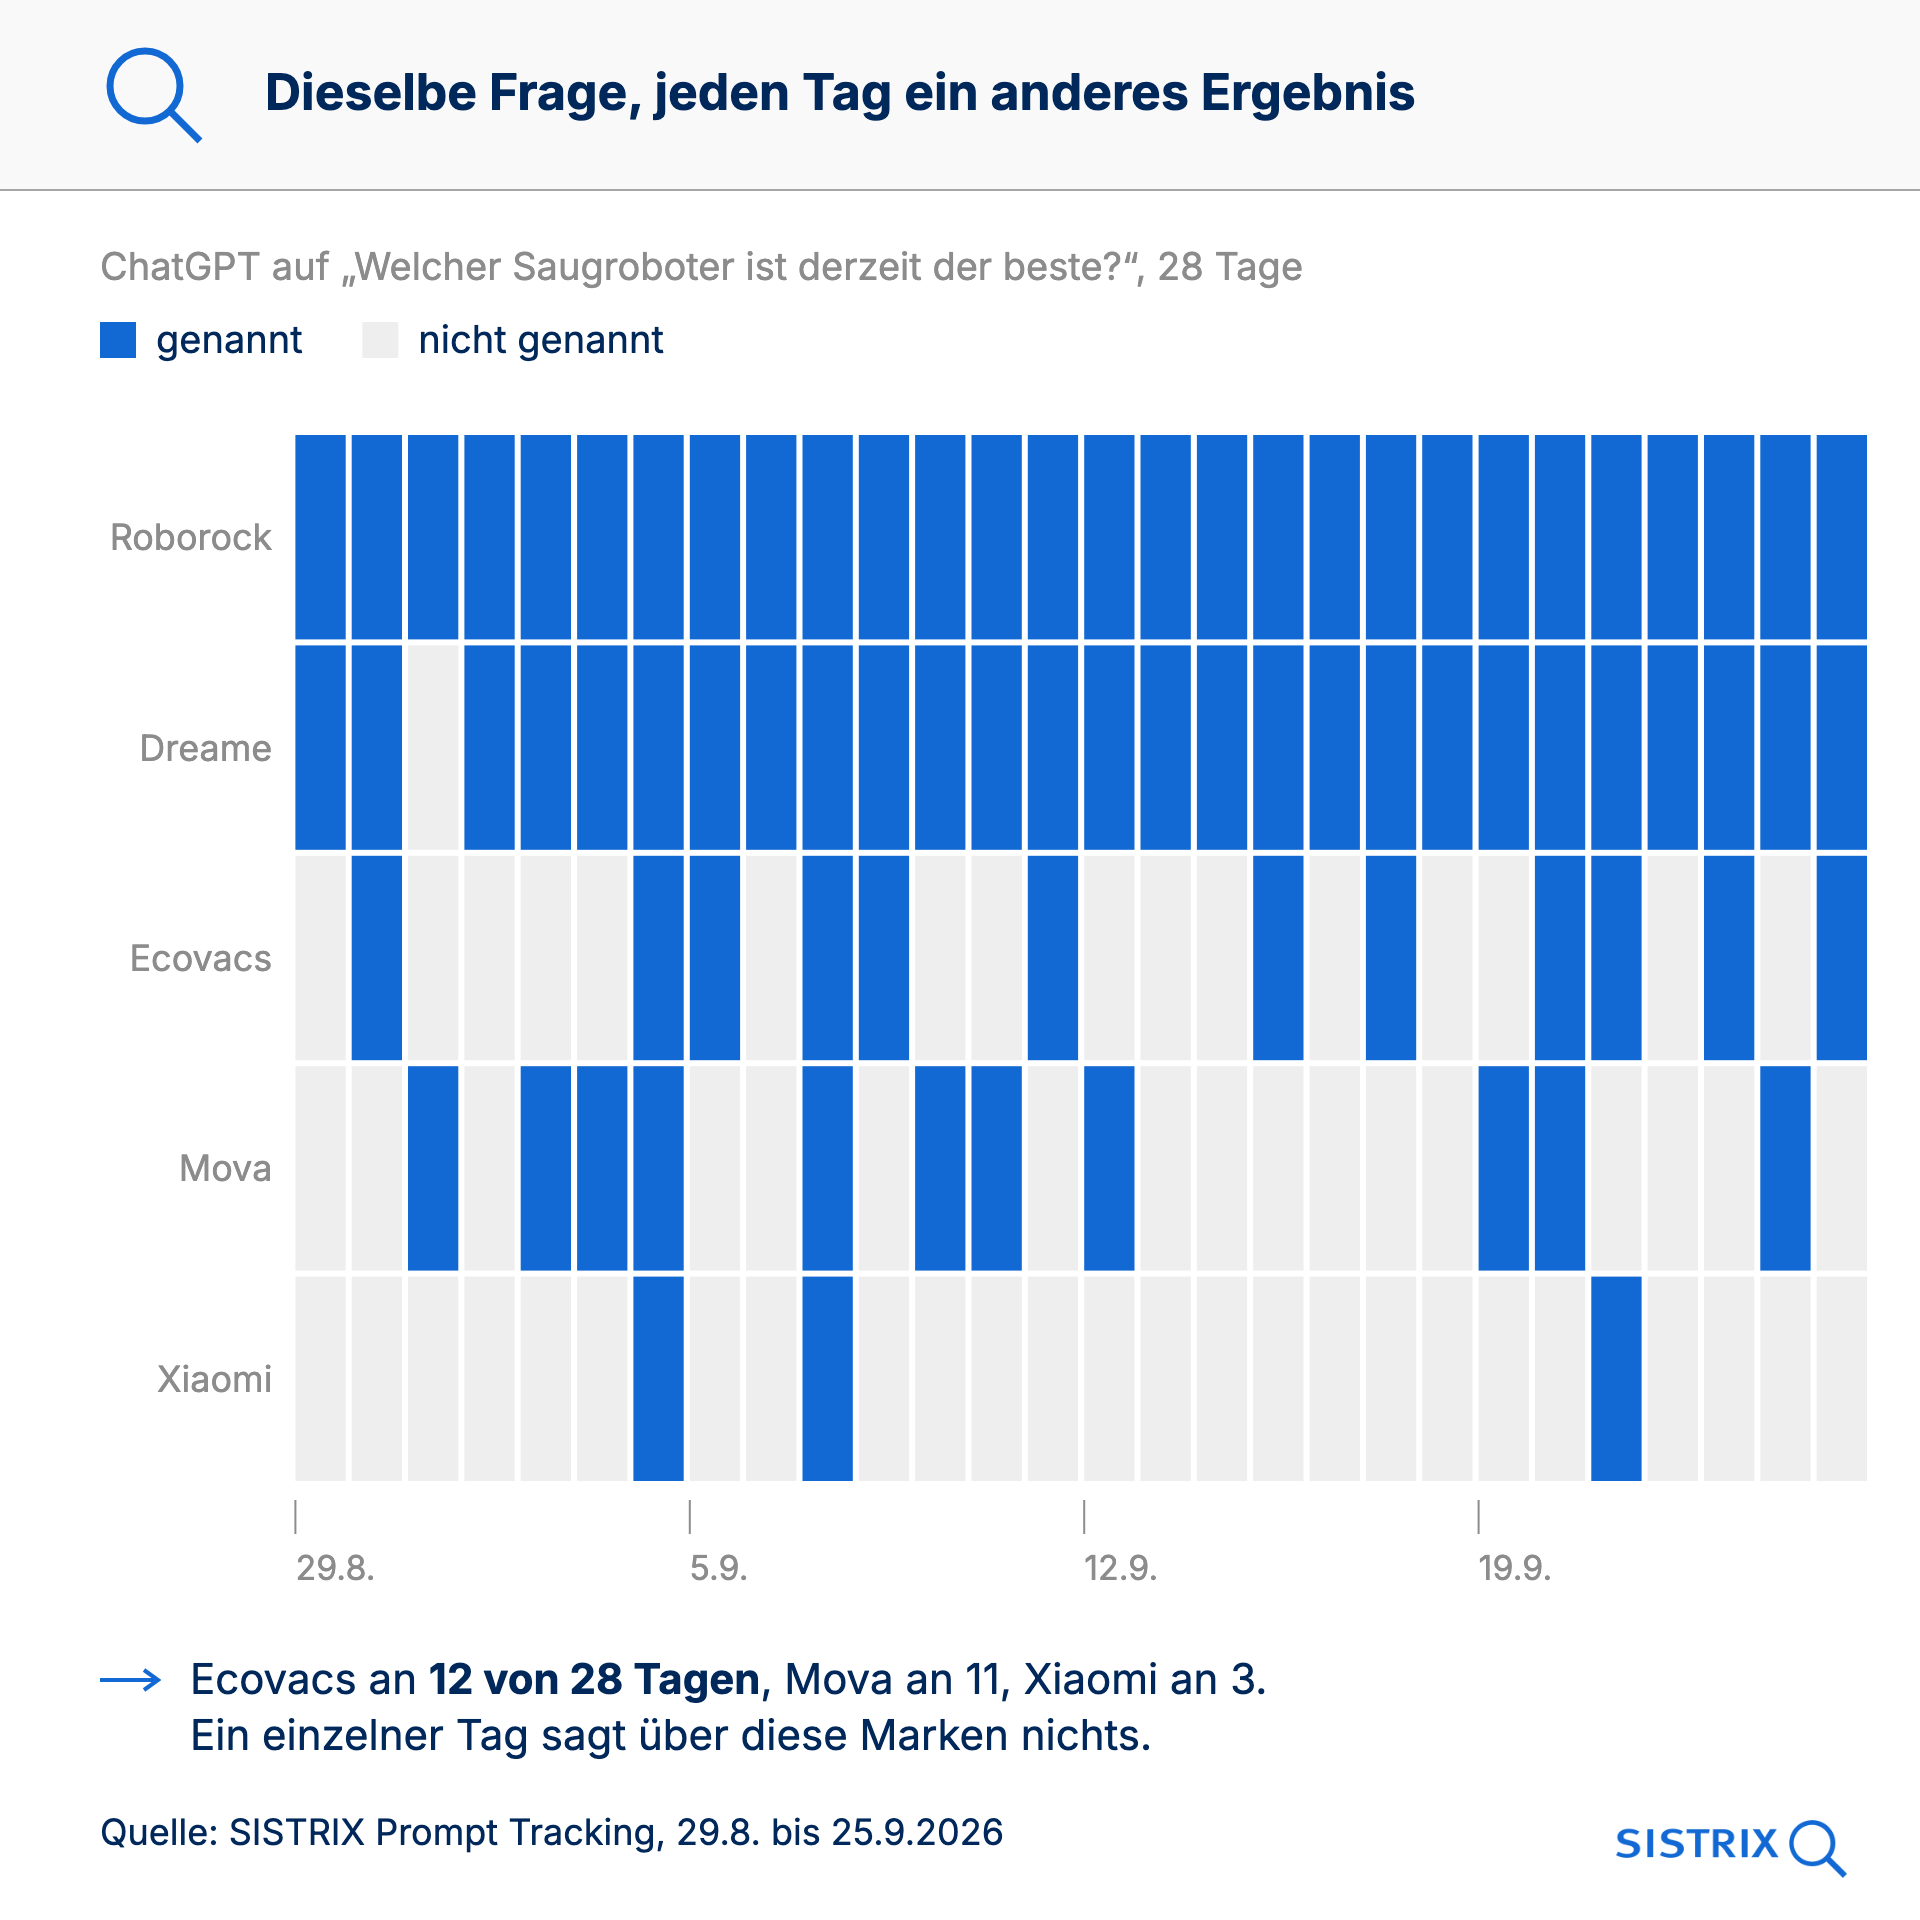
Ein Beispiel aus unserem Prompt Tracking: Wir fragen ChatGPT jeden Tag „Welcher Saugroboter ist derzeit der beste?“. Roborock und Dreame werden in vier Wochen fast täglich genannt. Ecovacs taucht an 12 von 28 Tagen auf, Mova an 11, Xiaomi an 3, ohne erkennbares Muster. Wer an einem einzelnen Tag nachschaut, erfährt über diese drei Marken also so gut wie nichts.
Einzelne AI-Antworten sind tatsächlich Zufall
Mike King von iPullRank hat kürzlich in einem lesenswerten Artikel mit dem Titel „There Is No ‚Accuracy‘ in AI Search Tracking – Only Precision“ gezeigt, wie stark AI-Antworten von Lauf zu Lauf schwanken. Er stützt sich dabei auf ein Experiment von Mike Sonders mit 12 Prompts und je 100 Läufen in ChatGPT: 72 Prozent der Marken tauchten in weniger als jeder fünften Antwort auf.
Unsere Daten bestätigen das auf sehr viel breiterer Basis. Von allen Marken, die in den Antworten eines Prompts vorkommen, erscheinen 70 Prozent an weniger als jedem fünften Tag. Nur 6 Prozent sind an mindestens vier von fünf Tagen dabei. Das gilt für ChatGPT, AI Overviews, AI Mode und Perplexity gleichermaßen.
Eine einzelne Antwort sagt also wenig. Die Frage ist, wie man aus vielen unsicheren Antworten eine verlässliche Zahl macht.
Die Kernfrage: Wiederholen oder verbreitern?
Angenommen, man hat ein Budget von 20 Abfragen. Man kann einen Prompt 20 Tage lang abfragen, 20 verschiedene Prompts je einmal oder alles dazwischen. Welche Verteilung liefert die genaueste Aussage zur Frage „In wie vielen Antworten kommt meine Marke vor?“
Die Antwort aus 10.826 Messreihen ist eindeutig. Angenommen, eine Marke steht in Wahrheit in 25 Prozent der Antworten. Wer einen Prompt an 20 Tagen abfragt, misst irgendwo zwischen 0 und 59 Prozent. Mit 20 verschiedenen Prompts an einem Tag liegt die Messung zwischen 16 und 35 Prozent, mit 100 Prompts zwischen 21 und 29 Prozent.
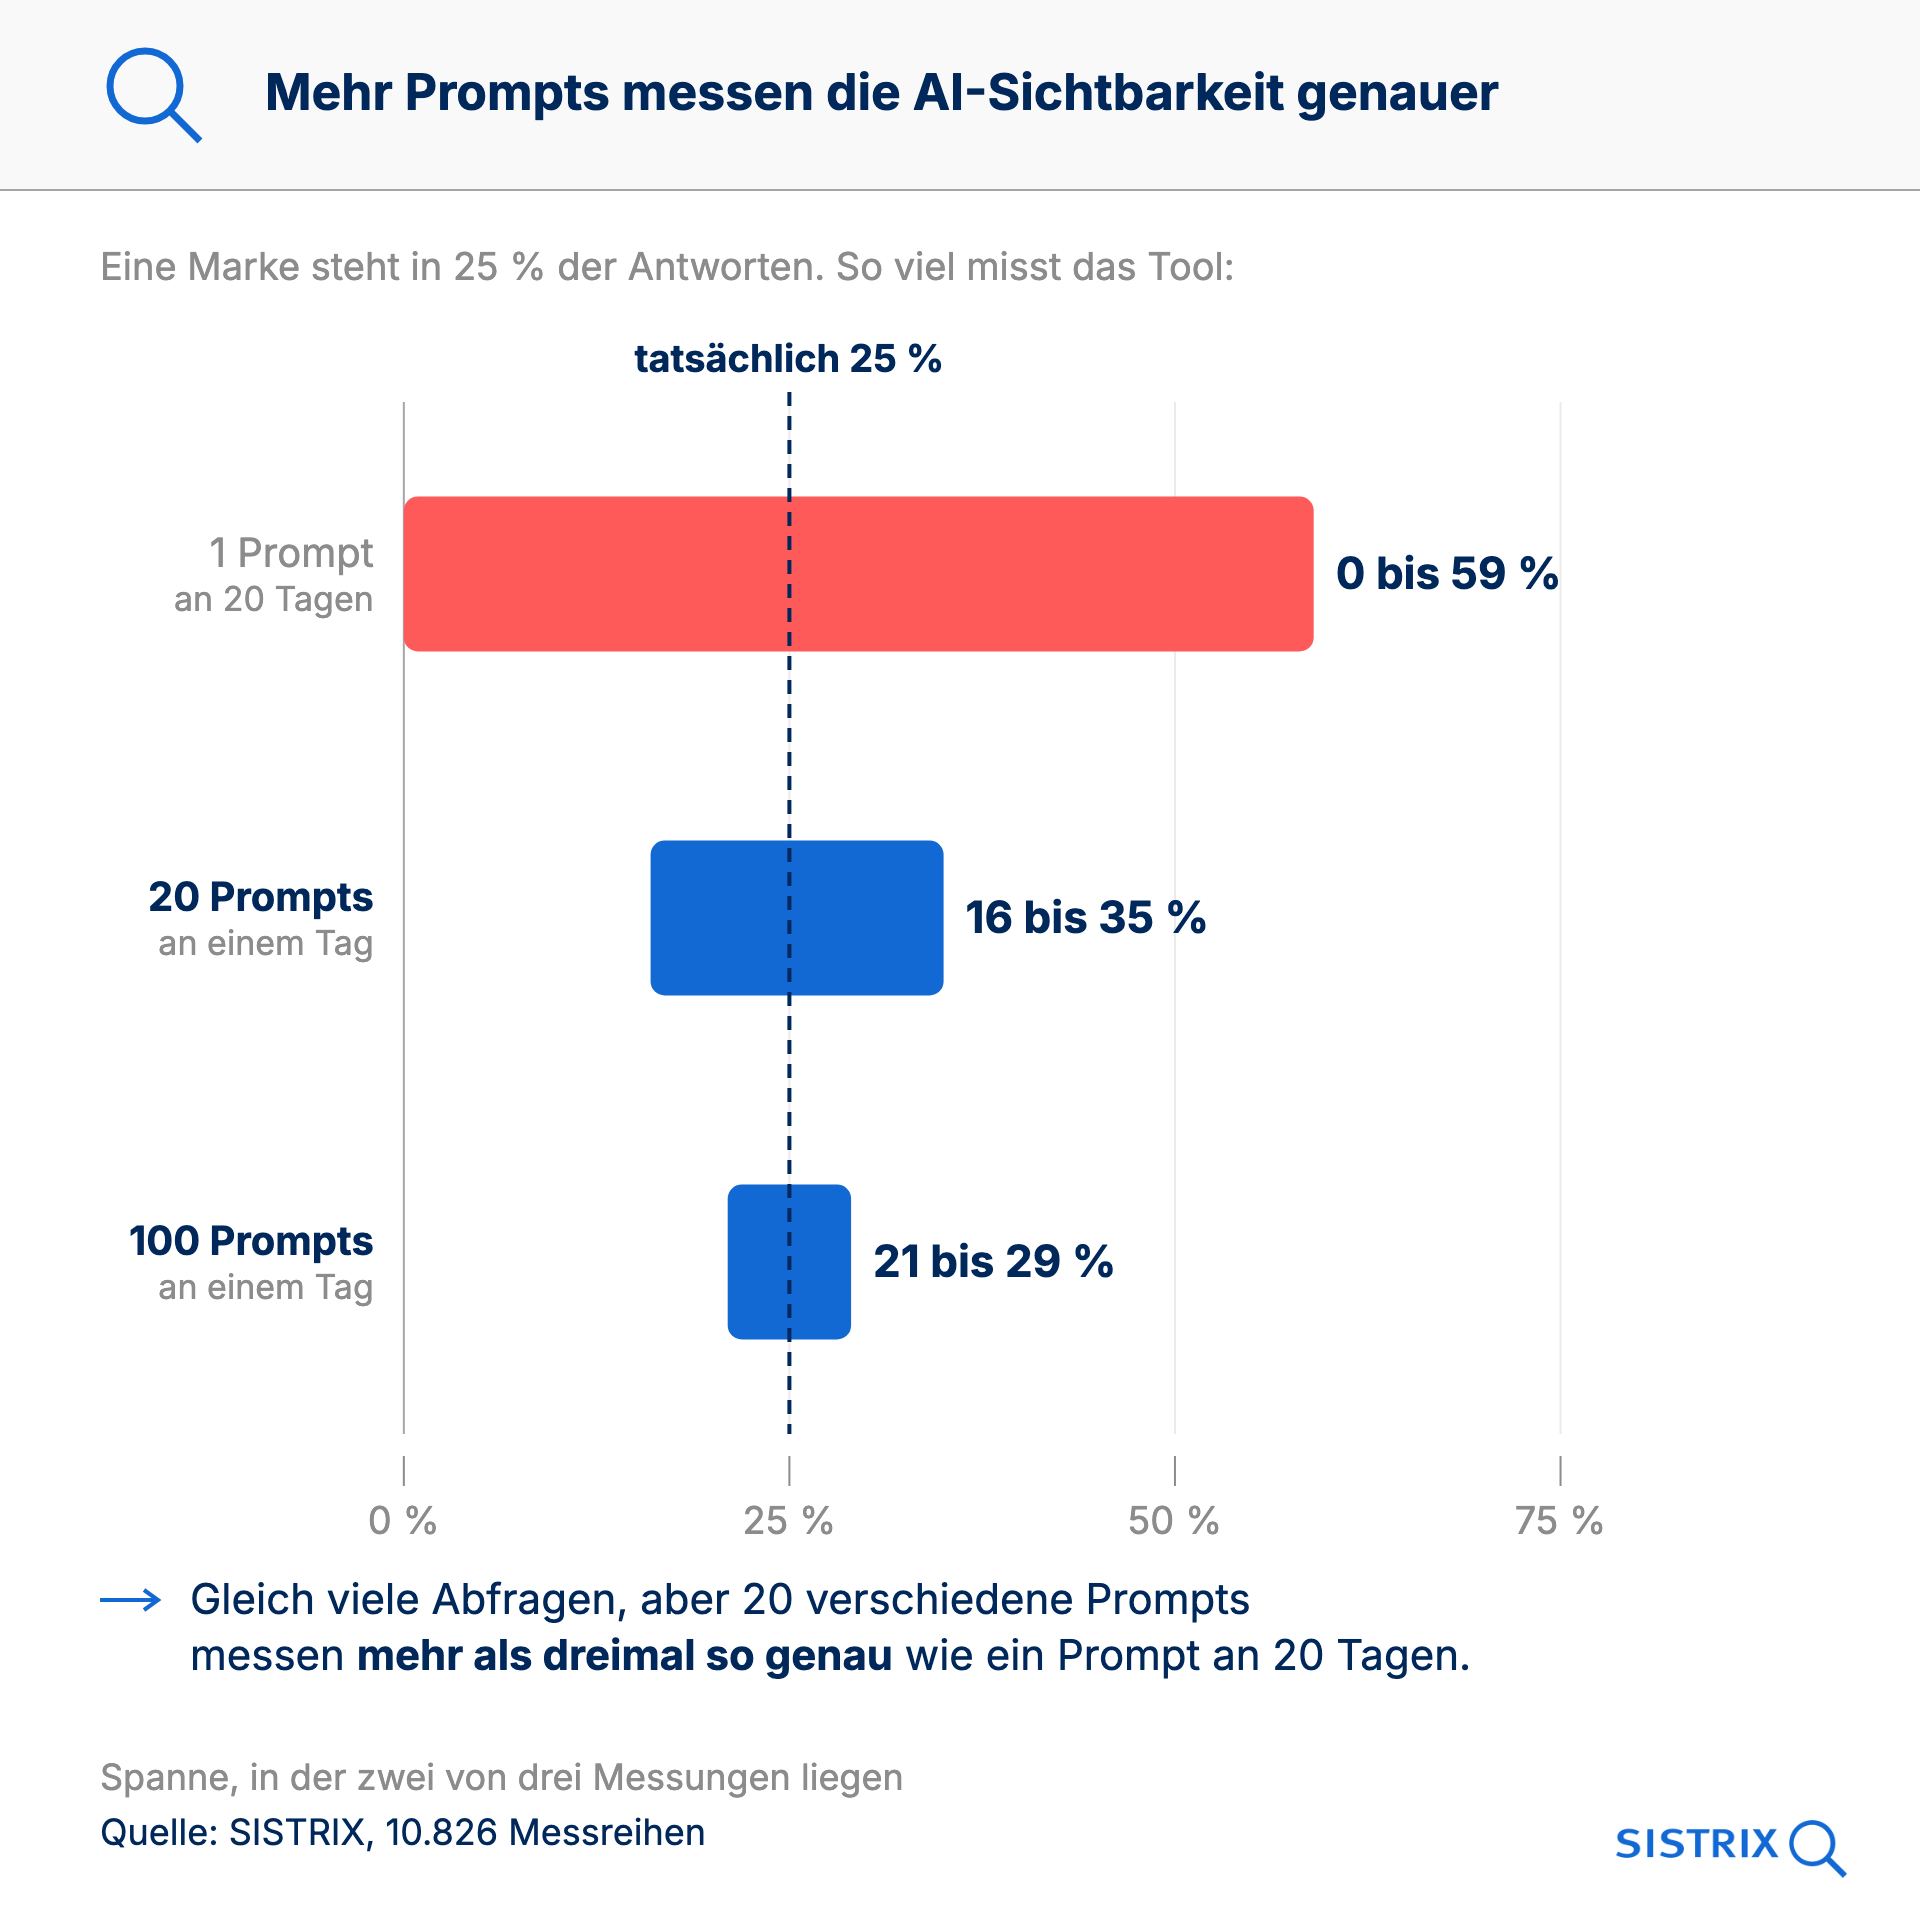
Hinter den Spannen stehen typische Abweichungen vom wahren Wert: ±34 Prozentpunkte bei einem Prompt, ±9,5 bei 20 und ±4,2 bei 100 Prompts. Typische Abweichung heißt: In rund zwei von drei Fällen liegt die Messung innerhalb dieser Spanne, in 95 Prozent der Fälle innerhalb der doppelten.
Bei gleichem Aufwand ist die Messung mit 20 verschiedenen Prompts mehr als dreimal so genau wie die mit einem Prompt an 20 Tagen. Dieses Bild ist in allen vier Modellen und allen acht Ländern nahezu identisch: Mit 20 Prompts liegt die Abweichung überall zwischen ±9 und ±10 Punkten.
Warum Breite gewinnt
Der Grund liegt in zwei Arten von Schwankung. Derselbe Prompt liefert von Tag zu Tag unterschiedliche Antworten. Verschiedene Prompts liefern aber noch viel unterschiedlichere: Bei der einen Frage ist die Marke fast immer dabei, bei der nächsten fast nie. Die Unterschiede zwischen Prompts sind im Mittel 2,4-mal so groß wie die Schwankung eines Prompts über die Tage.
Wiederholung bekämpft nur die kleinere der beiden Schwankungen. Mit 20 Prompts bleibt selbst bei beliebig vielen Wiederholungen eine Untergrenze von ±7,6 Punkten. Darunter kommt man nur mit mehr verschiedenen Prompts.
Für die Praxis heißt das: Wer AI-Sichtbarkeit für eine Marke messen will, sollte lieber 100 Prompts wöchentlich abfragen als 15 Prompts täglich. Der Aufwand ist ähnlich, die Aussage deutlich belastbarer.
Viele Prompts mitteln die Schwankung heraus
Wie gut das in der Praxis funktioniert, zeigt der SISTRIX AI Check. Wir haben für 60 Marken je Land in Deutschland, den USA, Großbritannien, Frankreich, Italien und Spanien verfolgt, wie sich ihre Zahlen von Woche zu Woche bewegen.
Von den Prompts, in denen eine Marke genannt wird, wechseln jede Woche zwischen 20 und 55 Prozent: Die Marke fällt aus Antworten heraus und taucht in anderen neu auf. Bei ChatGPT und AI Mode ist es rund die Hälfte, bei AI Overviews etwa jeder fünfte Prompt. Die Gesamtzahl der Nennungen ändert sich netto trotzdem meist nur um 4 bis 10 Prozent. Und je mehr Prompts eine Marke hat, desto ruhiger ist ihre Kurve. Bei Marken mit weniger als 100 Prompts schwankt die AI-Sichtbarkeit im Median um ±5,7 Prozent von Woche zu Woche, ab 10.000 Prompts nur noch um ±1,9 Prozent.
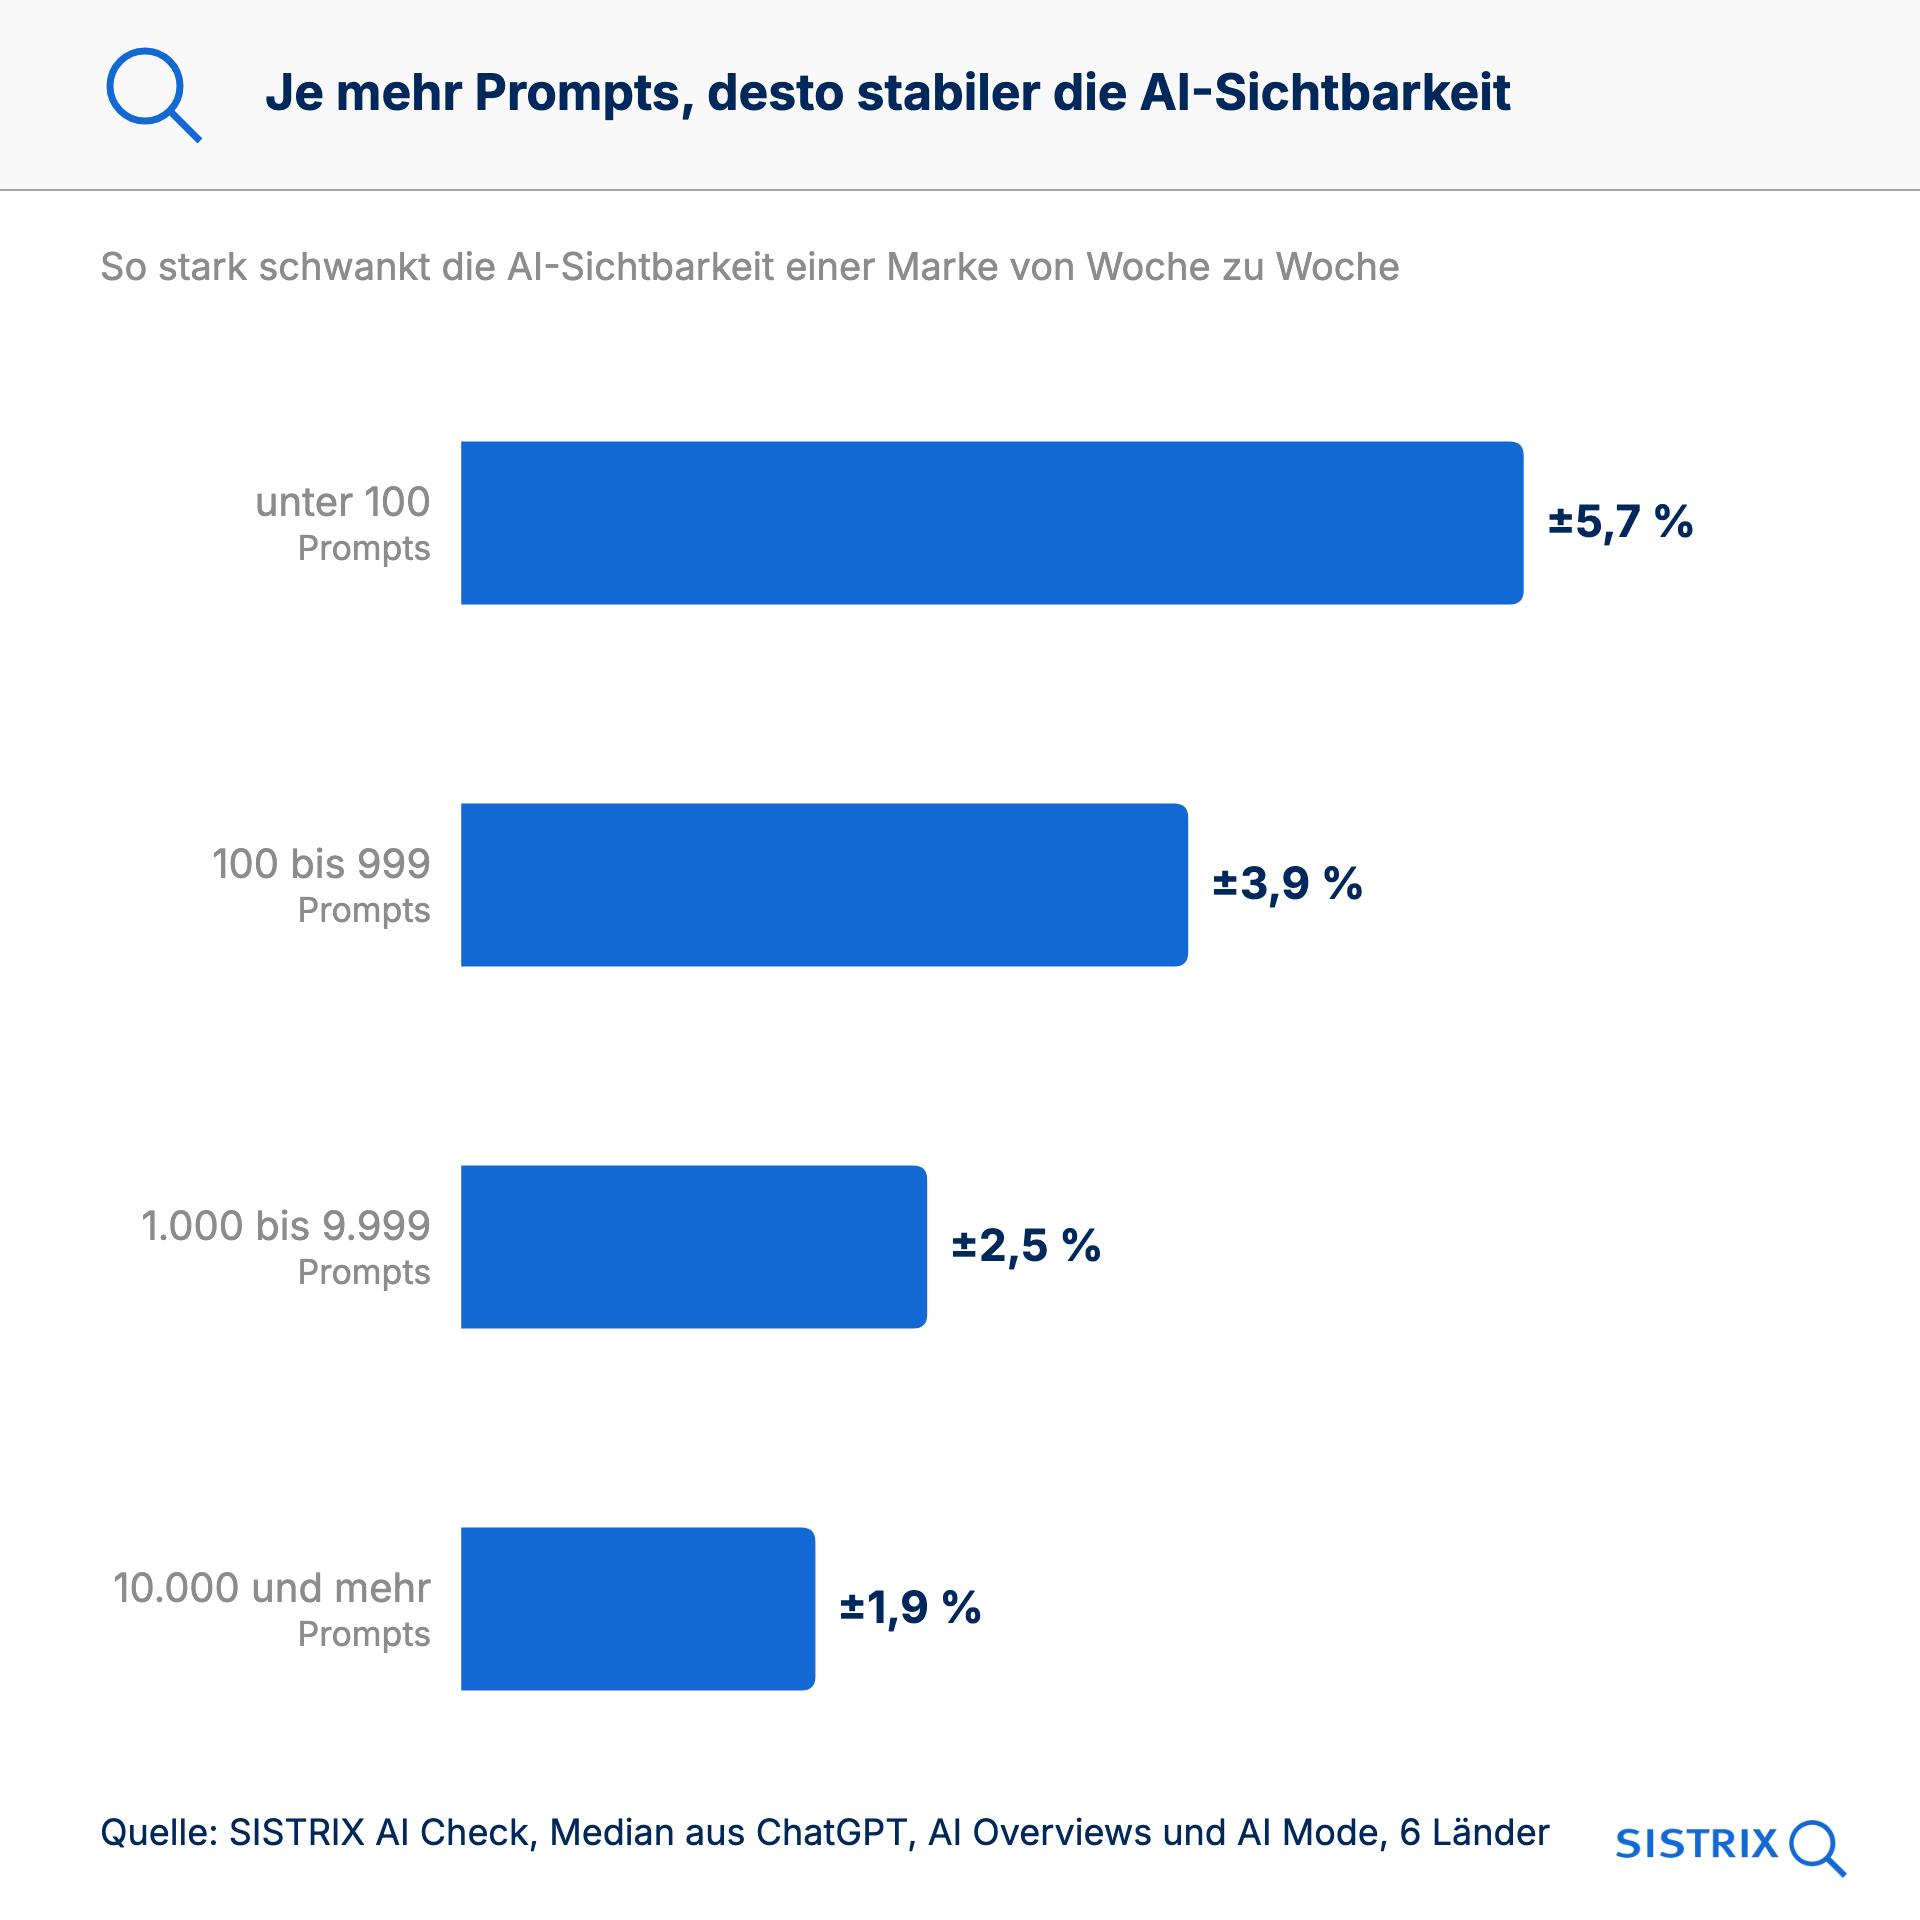
Gemessen ist die Abweichung vom eigenen Trend, bereinigt um Veränderungen des Gesamtbestands. Einzige Ausnahme sind sehr große Marken in AI Overviews mit ±3,1 Prozent: Dort schlagen Wechsel im Bestand der Prompts stärker durch als der Zufall der Antworten.
Einzelne Antworten schwanken stark, die Zahl über viele Prompts bleibt stabil. Genau das ist der Effekt, den man für eine verlässliche Messung braucht.
Wann tägliche Abfragen trotzdem sinnvoll sind
In einem Punkt hat iPullRank recht: Wiederholung ist nicht wertlos. Sie hilft nur bei einer anderen Frage.
„Wie sichtbar bin ich?“ beantwortet man mit Breite. „Hat sich etwas verändert?“ beantwortet man mit Wiederholung. Bleibt das Prompt-Set gleich, fällt der Unterschied zwischen den Prompts beim Vergleich heraus, und übrig bleibt nur die Schwankung von Tag zu Tag. Bei 20 Prompts liegt der Tageswert bei ±4,8 Punkten, das Mittel über eine Woche bei ±1,8 Punkten.
Wer also nach einer Maßnahme wissen will, ob sich etwas bewegt hat, sollte nicht einzelne Tage vergleichen, sondern Wochenmittel. Das Tagesmittel über 20 Prompts springt typischerweise um 4 bis 5 Punkte, an jedem zehnten Tag um 10 Punkte oder mehr, ohne dass sich irgendetwas verändert hat.
Viele Tools mitteln tägliche Werte deshalb über ein gleitendes 7-Tage-Fenster. Für Veränderungen ist das sinnvoll, für das Niveau bringt es wenig. 20 Prompts über sieben Tage messen auf ±7,9 Punkte genau, kaum besser als an einem einzigen Tag (±9,5). Selbst beliebig viele Tage kommen nicht unter ±7,6, denn das Fenster mittelt nur die Schwankung von Tag zu Tag heraus, nicht die Auswahl der Prompts. Dieselben 140 Abfragen als 140 verschiedene Prompts an einem Tag kommen dagegen auf ±3,6 Punkte.
Präzise ist nicht gleich richtig
iPullRank unterscheidet zwischen Präzision (wie stark streut eine Messung?) und Richtigkeit (liegt sie am wahren Wert?) und kommt zu dem Schluss, dass es bei AI-Sichtbarkeit keinen wahren Wert gibt, gegen den man Richtigkeit messen könnte.
Wir sehen das anders. Definiert man den wahren Wert als Nennungsrate über die Gesamtheit der Prompts eines Marktes, wie sie der AI Check abbildet, lässt sich Richtigkeit messen. Und sie ist der größere Fehler.
Wir haben die Sichtbarkeit von Marken in selbst gewählten Prompt-Sets mit ihrer Sichtbarkeit im AI Check verglichen, jeweils als Anteil gegenüber den Wettbewerbern. Gäbe es keinen Auswahleffekt, läge das eigene Set mal darüber und mal darunter, wäre also in etwa der Hälfte der Fälle besser. Tatsächlich schneidet die eigene Marke in drei von vier Fällen besser ab, meist deutlich. Je nachdem, welche Wettbewerber man zum Vergleich heranzieht, sind es 63 bis 80 Prozent.
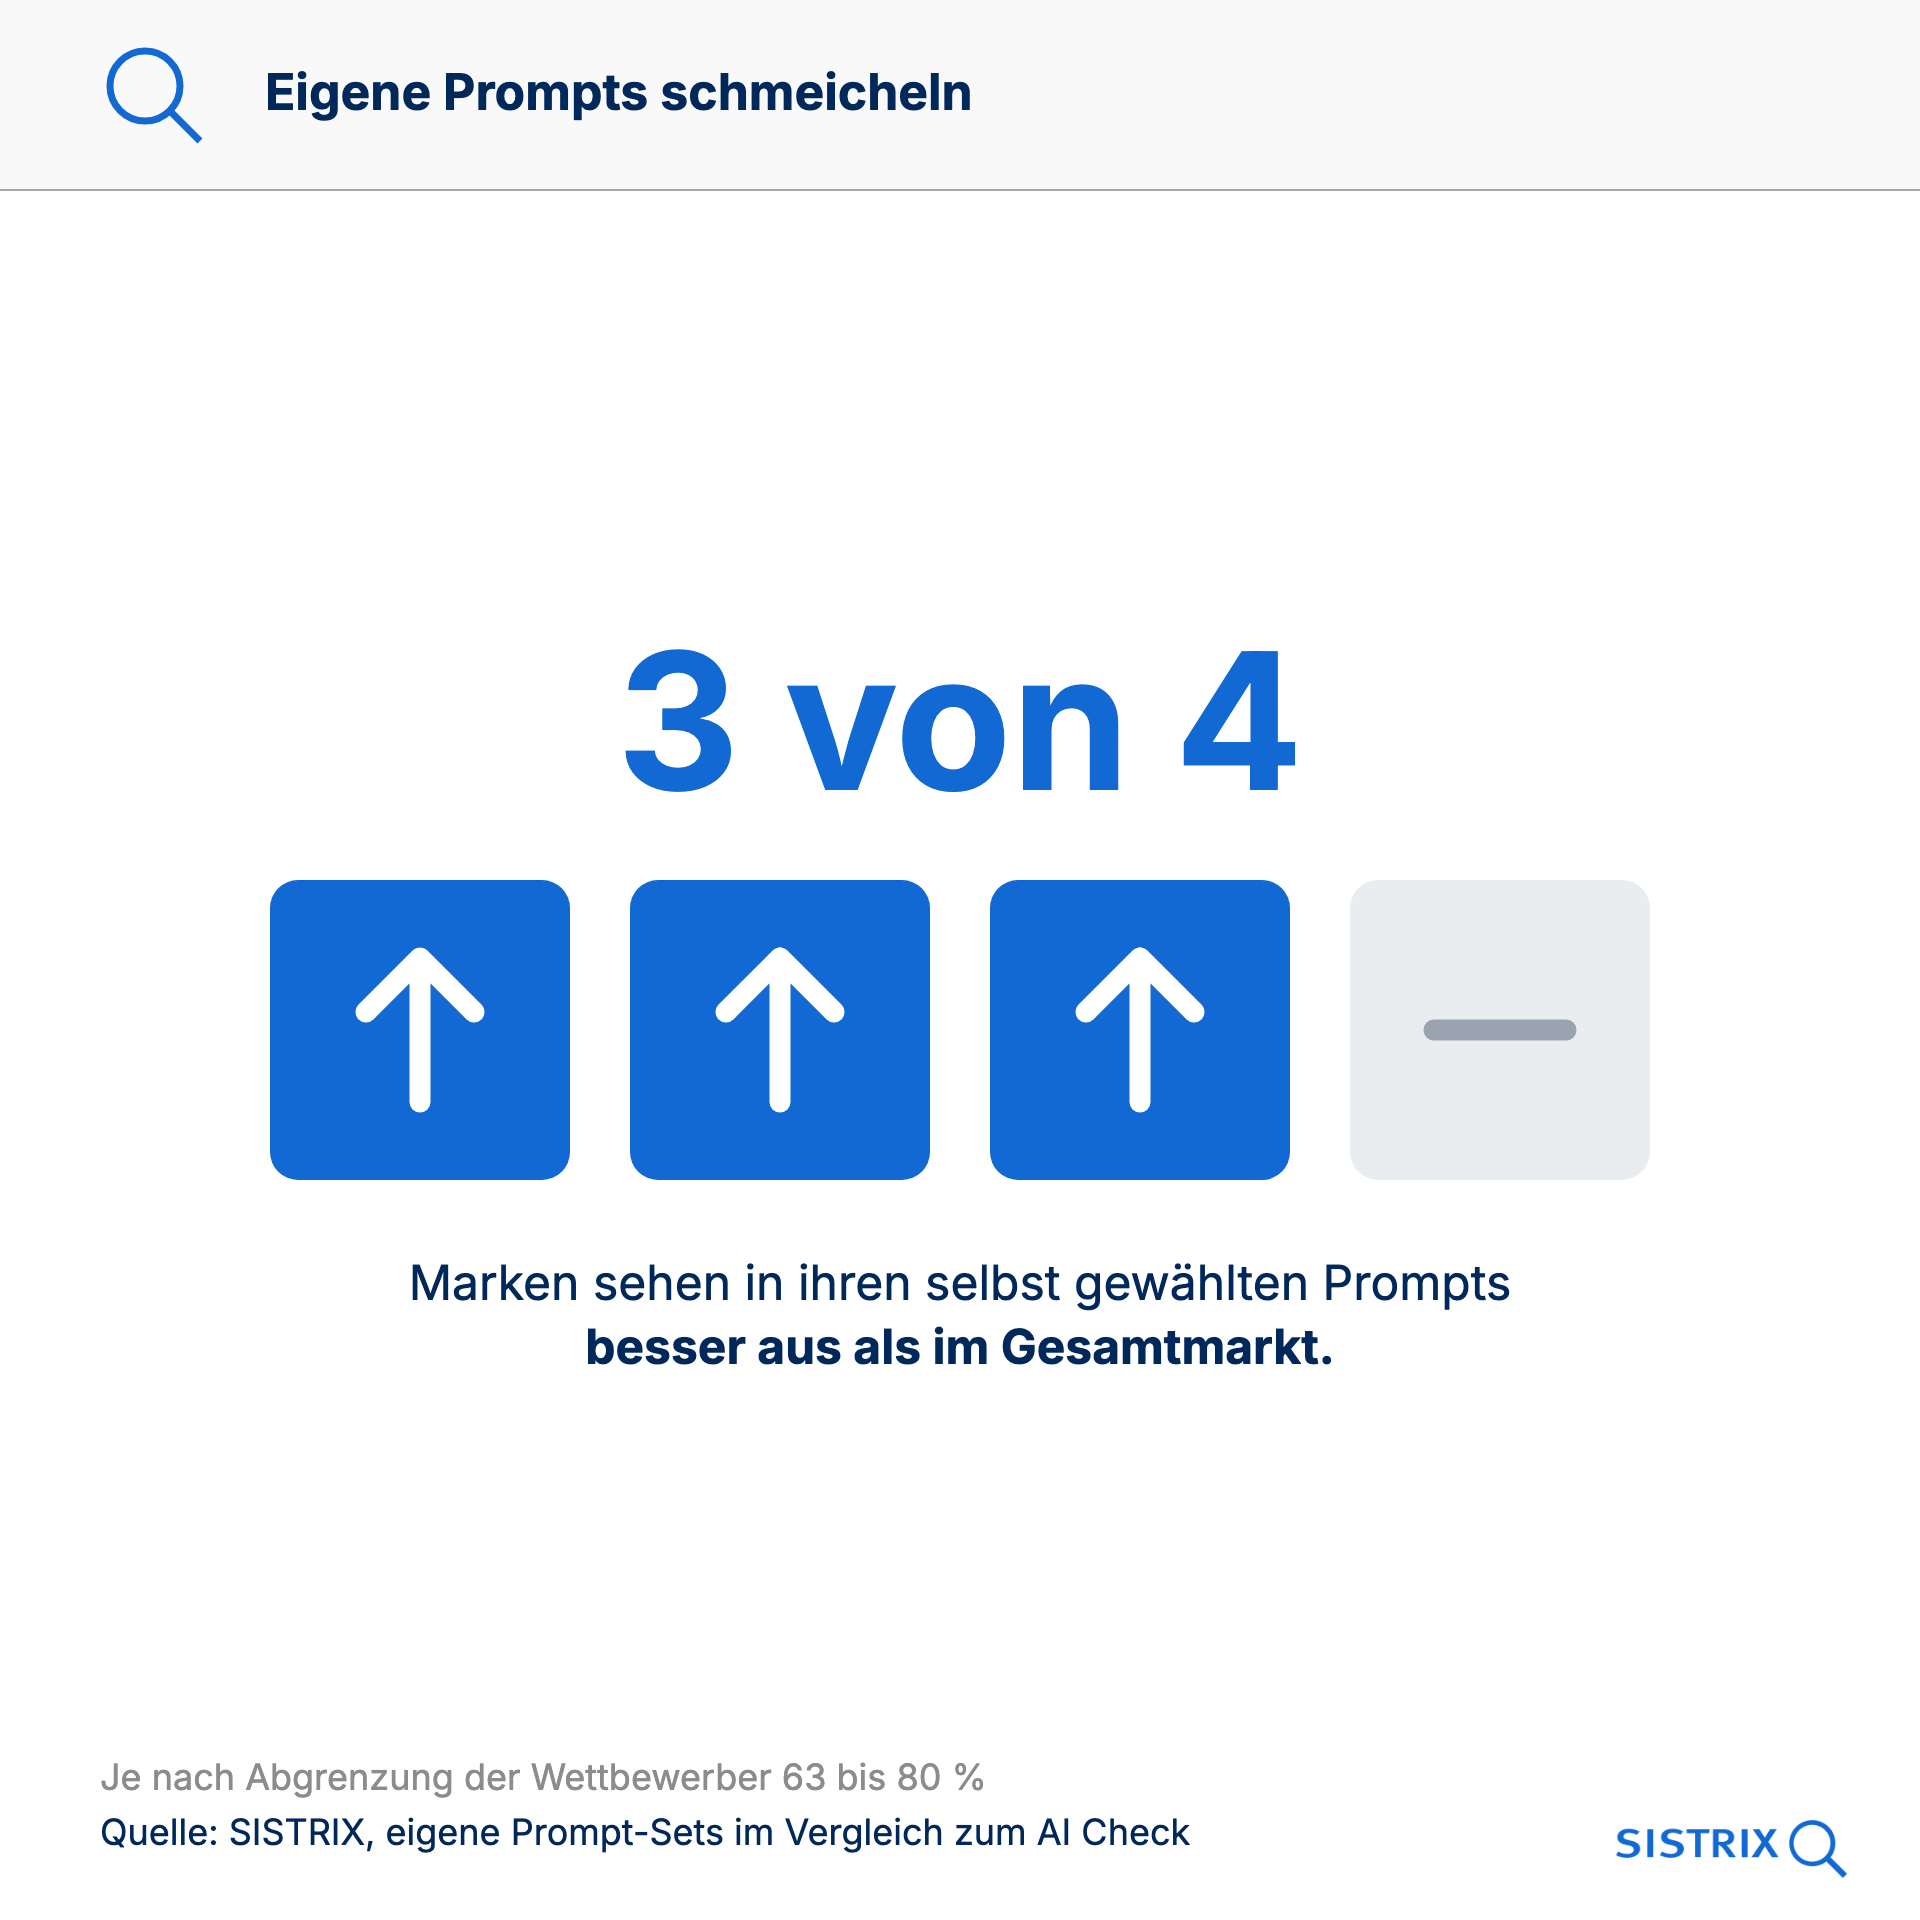
Das ist kein Messfehler, sondern ein Auswahleffekt. Wer Prompts selbst auswählt, wählt Fragen, die nah an der eigenen Marke liegen. Das Instrument ist präzise, zielt aber daneben, wie der zweite Dartspieler im Bild aus dem iPullRank-Artikel.
Im eigenen Set: stabil für die eigene Marke, unsicher für Wettbewerber
Ein letzter Befund relativiert das Bild vom „Würfelwurf“. In selbst gewählten Prompt-Sets weicht die eigene Marke nur in 6 Prozent der täglichen Läufe von ihrem üblichen Ergebnis ab. Die meisten Prompts nennen sie fast immer oder fast nie.
Das liegt auch an der Auswahl: Wer die Prompts rund um die eigene Marke zusammenstellt, misst die eigene Marke gut und alle anderen nur am Rand. Unsicher sind deshalb vor allem Aussagen über Wettbewerber und Randmarken, also die 70 Prozent, die nur an wenigen Tagen auftauchen. Wer aus einem kleinen eigenen Prompt-Set ableitet, dass ein Wettbewerber zugelegt hat, sollte vorsichtig sein. Für den Vergleich mit Wettbewerbern ist ein Bestand besser, der nicht nach einer Marke ausgesucht wurde.
Was daraus folgt
Fünf Empfehlungen für alle, die AI-Sichtbarkeit messen:
- Mehr Prompts statt mehr Läufe. Für die Frage „Wie sichtbar bin ich?“ ist die Zahl verschiedener Prompts der entscheidende Hebel. 20 Prompts reichen nur für eine grobe Einordnung (±10 Punkte). Für ±5 Punkte braucht es rund 70 Prompts, für ±3 Punkte rund 200. Als Faustregel gilt: Wer die Unschärfe halbieren will, braucht viermal so viele Prompts.
- Wöchentlich reicht für die Breite. Ein großes Prompt-Set wöchentlich ist verlässlicher als ein kleines täglich. Bei gleich vielen Abfragen messen 140 Prompts einmal pro Woche auf ±3,6 Punkte genau, 20 Prompts täglich mit 7-Tage-Fenster nur auf ±7,9. Wer das Budget hat, sollte es in zusätzliche Prompts stecken, nicht in häufigere Abfragen.
- Veränderungen über Wochenmittel bewerten. Tageswerte springen ohne Grund um 5 bis 10 Punkte. Wer bei einem festen Prompt-Set wissen will, ob eine Maßnahme wirkt, sollte Wochenmittel vergleichen. Bei 20 Prompts liegt deren Unschärfe bei ±1,8 Punkten, ein einzelner Tag dagegen bei ±4,8.
- Das Niveau am Markt messen, Veränderungen im eigenen Set. Selbst gewählte Prompts zeigen Trends zuverlässig, das absolute Niveau aber meist zu günstig. Für die Frage, wie sichtbar die eigene Marke wirklich ist, taugt ein breiter Prompt-Bestand wie der SISTRIX AI Check besser als jedes selbst gewählte Set. Am aussagekräftigsten sind dort Anteile wie der Share of Voice, weil sie Veränderungen im Gesamtbestand ausgleichen.
- Wettbewerberzahlen aus dem eigenen Set mit Vorsicht lesen. Ein selbst gewähltes Prompt-Set ist auf die eigene Marke zugeschnitten, Wettbewerber tauchen darin nur am Rand auf und schwanken deutlich stärker. Im AI Check gilt das nicht: Dort wird jede Marke gleich gemessen, und wie ruhig ihre Zahl ist, hängt nur davon ab, in wie vielen Prompts sie vorkommt.
Daraus ergibt sich eine einfache Arbeitsteilung. Wie sichtbar eine Marke ist, zeigt der Blick über sehr viele Prompts, die nicht nach der eigenen Marke ausgesucht wurden: Im AI Check schwankt die AI-Sichtbarkeit von Marken mit mehr als 1.000 Prompts nur um ±1 bis 3 Prozent pro Woche. Ob eine Maßnahme wirkt, zeigt ein festes Prompt-Set im Prompt Tracking, das täglich abgefragt und über Wochen gemittelt wird. Wer beides trennt, bekommt eine Zahl, die stimmt, und eine Kurve, die Veränderungen zuverlässig anzeigt.