

Der Googlebot ist der Webcrawler von Google. Er ruft Webseiten und andere öffentlich erreichbare Ressourcen ab und schafft damit eine Voraussetzung dafür, dass Google Inhalte verarbeiten und in der Suche berücksichtigen kann.
- Was ist der Googlebot?
- So funktioniert der Googlebot
- Warum ist der Googlebot für SEO wichtig?
- Googlebot mit robots.txt steuern und blockieren
- Die gesamte Website für den Googlebot sperren
- Einzelne Verzeichnisse für den Googlebot sperren
- Einzelne Dateien für den Googlebot sperren
- Alle Crawler über robots.txt ansprechen
- Warum robots.txt eine URL nicht zuverlässig aus Google entfernt
- robots.txt, noindex oder Canonical: Welche Methode ist richtig?
- Crawling mit interner Verlinkung und XML-Sitemap verbessern
- Crawl Budget: Wann wird die Steuerung des Googlebots wichtig?
- Googlebot und KI: Crawling und Nutzung gezielt steuern
- Crawling nach dem SEO-Ziel planen
- Googlebot mit Search Console und SISTRIX prüfen
- Häufige Fehler bei der Steuerung des Googlebots
- Häufige Fragen zum Googlebot
Für Website-Betreiber stellt sich heute allerdings nicht mehr nur die Frage, ob der Googlebot eine URL crawlen darf. Ebenso relevant ist, ob eine Seite indexiert und für AI Overviews, den KI-Modus oder andere KI-Produkte von Google verwendet werden darf.
Diese Ebenen lassen sich getrennt steuern. Die robots.txt regelt das Crawling. noindex steuert die Indexierung. nosnippet und data-nosnippet beeinflussen die Verwendung von Inhalten in Such-Snippets und Googles KI-Suchfunktionen.
Mit Google-Extended lässt sich wiederum die Nutzung für Gemini einschränken, ohne die Google-Suche zu blockieren.
Die wichtigste Regel lautet deshalb: Bevor du den Googlebot blockierst, musst du festlegen, was Google mit dem Inhalt nicht tun soll. Crawling, Indexierung und KI-Nutzung erfordern unterschiedliche technische Maßnahmen.
Was ist der Googlebot?
Googlebot ist die Bezeichnung für die Webcrawler, die Google für die Google-Suche einsetzt. Ein Crawler ruft URLs automatisiert ab. Dadurch kann Google neue Seiten entdecken, bereits bekannte Seiten erneut besuchen und Änderungen an vorhandenen Inhalten erfassen.
Google unterscheidet beim allgemeinen Googlebot zwischen zwei Varianten:
- Googlebot Smartphone simuliert einen Nutzer auf einem Mobilgerät.
- Googlebot Desktop simuliert einen Nutzer auf einem Desktop-Gerät.
Für die Indexierung und das Ranking verwendet Google die mobile Version einer Website. Entsprechend ist Googlebot Smartphone für SEO heute die entscheidende Variante. Wichtige Inhalte, interne Links und Ressourcen müssen deshalb auch mobil verfügbar und für Google erreichbar sein.
Beide Varianten verwenden in der robots.txt das User-Agent-Token Googlebot und lassen sich dort nicht separat steuern.
Daneben betreibt Google weitere Crawler und Fetcher für spezielle Produkte und Aufgaben. Dazu gehören etwa Googlebot-Image und Googlebot-News. Googles Crawling-Infrastruktur wird außerdem von verschiedenen Produkten wie Search, Shopping, News und Gemini genutzt.
Davon zu unterscheiden ist Google-Extended. Google-Extended ist kein eigener HTTP-Crawler. Es handelt sich um ein Steuerungs-Token für die robots.txt, mit dem Website-Betreiber bestimmte Verwendungen ihrer Inhalte für Googles generative KI-Produkte kontrollieren können.
So funktioniert der Googlebot
Damit eine Webseite über die Google-Suche gefunden werden kann, muss Google zunächst von ihrer URL erfahren. Das geschieht unter anderem über Links und XML-Sitemaps.
Anschließend kann der Googlebot die URL abrufen. Bei Webseiten werden dabei auch Ressourcen relevant, die Google zum Rendern benötigt, etwa CSS- und JavaScript-Dateien. Google nennt in seiner aktuellen robots.txt-Dokumentation selbst das Beispiel, dass solche Ressourcen für das Rendering durch Googlebot erreichbar sein sollten.
Auf das Crawling folgt die weitere Verarbeitung durch Googles Systeme. Dabei muss zwischen drei Vorgängen unterschieden werden:
Crawling: Googlebot ruft die URL und ihre Ressourcen ab.
Indexierung: Google verarbeitet den Inhalt und entscheidet, ob und wie er in den Suchindex aufgenommen wird.
Ausspielung: Google entscheidet anhand der Suchanfrage, welche indexierten Inhalte in welcher Form in der Suche erscheinen.
Eine gecrawlte URL wird deshalb nicht automatisch indexiert. Ebenso garantiert eine indexierte Seite kein Ranking für eine bestimmte Suchanfrage.
Diese Trennung ist entscheidend, wenn du Google technisch steuern möchtest. Wer eine URL aus dem Index entfernen will, braucht eine andere Anweisung als jemand, der lediglich das Crawling bestimmter URL-Bereiche verhindern möchte.
Warum ist der Googlebot für SEO wichtig?
Der Googlebot ist für SEO relevant, weil Google aktuelle Inhalte nur verarbeiten kann, wenn seine Systeme sie erreichen. Eine versehentliche Crawling-Sperre kann dazu führen, dass Google Änderungen an einer Seite nicht abrufen kann.
Das betrifft nicht nur HTML-Seiten. Werden wichtige CSS- oder JavaScript-Ressourcen blockiert, kann dies Googles Rendering beeinträchtigen.
Gleichzeitig ist möglichst viel Crawling kein Optimierungsziel. Bei großen Websites entstehen schnell Tausende oder Millionen URLs ohne eigenständigen Suchwert. Typische Ursachen sind Filter, Sortierungen, Kalender, interne Suchfunktionen und URL-Parameter.
Die technische Aufgabe lautet deshalb: Googlebot sollte die für die Suche relevanten Inhalte zuverlässig erreichen können, ohne unnötig große URL-Mengen crawlen zu müssen.
Googlebot mit robots.txt steuern und blockieren
Die robots.txt ist die zentrale Datei zur Steuerung des Crawlings. Google ruft sie ab, bevor seine automatisierten Crawler eine Website crawlen, und prüft anhand der enthaltenen Regeln, welche Bereiche erreichbar sein dürfen.
Die Datei muss als UTF-8-codierte Textdatei im Stammverzeichnis liegen. Für https://example.com/ lautet die Adresse:
https://example.com/robots.txt
Ihre Regeln gelten nur für den jeweiligen Host, das Protokoll und den Port. Die Datei unter https://example.com/robots.txt steuert deshalb nicht automatisch das Crawling von https://shop.example.com/ oder http://example.com/.
Google unterstützt in der robots.txt insbesondere die Felder user-agent, allow, disallow und sitemap. Ein crawl-delay wird von Google nicht unterstützt.
Die gesamte Website für den Googlebot sperren
Soll der Googlebot keine URL der Website crawlen, lautet die Anweisung:
User-agent: Googlebot
Disallow: /
User-agent bestimmt, für welchen Crawler die nachfolgenden Regeln gelten. Disallow: / schließt den gesamten URL-Pfad ab dem Stammverzeichnis vom Crawling aus.
Auf einer produktiven Website sollte eine solche Regel nur sehr gezielt eingesetzt werden. Ein Disallow: /, das nach einem Relaunch oder dem Wechsel von einer Staging- auf eine Live-Umgebung versehentlich bestehen bleibt, kann das Crawling der gesamten Website verhindern. Google nennt verbliebene robots.txt-Sperren ausdrücklich als möglichen Fehler bei Website-Migrationen.
Einzelne Verzeichnisse für den Googlebot sperren
Häufig soll nicht die gesamte Website blockiert werden, sondern lediglich ein bestimmter Bereich:
User-agent: Googlebot
Disallow: /admin/
Googlebot darf URLs unter diesem Pfad dann nicht crawlen.
Das kann bei URL-Bereichen sinnvoll sein, deren Inhalte für die Google-Suche keine Rolle spielen und die nicht von Google abgerufen werden sollen.
Einzelne Dateien für den Googlebot sperren
Auch konkrete Dateien lassen sich über ihren Pfad ausschließen:
User-agent: Googlebot
Disallow: /internes-dokument.pdf
Eine robots.txt-Sperre ist allerdings kein Zugriffsschutz. Die Datei bleibt grundsätzlich öffentlich erreichbar. Zudem ist die robots.txt selbst öffentlich einsehbar.
Sensible Dokumente, personenbezogene Daten und interne Bereiche müssen deshalb über Authentifizierung oder andere Zugriffskontrollen geschützt werden.
Alle Crawler über robots.txt ansprechen
Soll eine Regel für alle Crawler gelten, die das Robots Exclusion Protocol beachten, wird ein Asterisk verwendet:
User-agent: *
Disallow: /
robots.txt ist dabei eine Anweisung für kooperierende Crawler. Sie verhindert technisch nicht, dass ein Bot, der das Protokoll ignoriert, eine öffentlich erreichbare URL abruft.
Warum robots.txt eine URL nicht zuverlässig aus Google entfernt
Eine Sperre in der robots.txt verhindert das Crawling, entfernt eine URL aber nicht zuverlässig aus Google. Kennt Google die URL beispielsweise über Links, kann sie weiterhin in den Suchergebnissen erscheinen, obwohl Google ihren Inhalt nicht crawlen kann.
Soll eine URL nicht in den Google-Suchergebnissen erscheinen, verwende noindex:
<meta name=“robots“ content=“noindex“>
Für Nicht-HTML-Dateien wie PDFs kann noindex über den HTTP-Header ausgeliefert werden:
X-Robots-Tag: noindex
Googlebot muss die URL crawlen können, damit Google die noindex-Anweisung erkennt. Blockiere eine URL deshalb nicht gleichzeitig per robots.txt, wenn Google dort ein noindex auslesen soll.
robots.txt, noindex oder Canonical: Welche Methode ist richtig?
Die richtige technische Maßnahme hängt davon ab, welches Problem gelöst werden soll.
| Ziel | Methode |
|---|---|
| Googlebot soll eine URL nicht crawlen | robots.txt |
| Eine URL soll nicht in Google erscheinen | noindex |
| Nicht-HTML-Datei soll nicht indexiert werden | X-Robots-Tag: noindex |
| Ähnliche oder doppelte URLs sollen konsolidiert werden | Canonical |
| Text soll nicht für Snippets, AI Overviews und KI-Modus verwendet werden | nosnippet |
| Verwendbare Textmenge für Snippets, AI Overviews und KI-Modus soll begrenzt werden | max-snippet |
| Einzelne Textbereiche sollen nicht für Snippets, AI Overviews und KI-Modus verwendet werden | data-nosnippet |
| Bestimmte Nutzungen für Gemini sollen eingeschränkt werden | Google-Extended |
| Inhalte sollen vor unbefugtem Zugriff geschützt werden | Authentifizierung/Zugriffsschutz |
Crawling mit interner Verlinkung und XML-Sitemap verbessern
Eine gute interne Verlinkung hilft Googlebot, relevante Seiten zu finden und die Struktur einer Website zu erfassen. Beim Crawlen folgt Google Links von bereits bekannten Seiten und entdeckt darüber weitere URLs. Seiten, die häufig und von wichtigen Seiten intern verlinkt werden, sind für Google zudem leichter erreichbar.
Zusätzlich kannst du Google eine XML-Sitemap mit den relevanten URLs bereitstellen. Sie lässt sich in der Google Search Console einreichen und in der robots.txt angeben:
Sitemap: https://example.com/sitemap.xml
Die Sitemap ergänzt die interne Verlinkung um eine maschinenlesbare Übersicht der URLs, die gecrawlt werden sollen.
Auch die Serverleistung beeinflusst das Crawling. Reagiert ein Server langsam oder erreicht seine Kapazitätsgrenzen, kann Google die Crawling-Aktivität reduzieren.
Crawl Budget: Wann wird die Steuerung des Googlebots wichtig?
Bei sehr großen Websites reicht es nicht, nur zu prüfen, ob Google einzelne Seiten erreichen kann. Dann stellt sich zusätzlich die Frage, welche URLs Google mit seinen verfügbaren Crawling-Ressourcen verarbeitet.
Relevant wird das vor allem bei Websites mit sehr vielen technisch erzeugten URLs. Typische Beispiele sind:
- große Onlineshops mit Filtern und Sortierungen
- umfangreiche Publisher
- URL-Parameter mit vielen Kombinationen
- facettierte Navigationen
- große Mengen ähnlicher oder duplizierter URLs
- sehr häufig aktualisierte Inhalte
Für kleine und mittelgroße Websites ist eine eigenständige Crawl-Budget-Optimierung dagegen selten der erste technische SEO-Hebel. Hier sind eine saubere Informationsarchitektur, gute interne Verlinkung, korrekte Indexierungsanweisungen und funktionierende Sitemaps meist wichtiger.
Ein paar tausend URLs sind für Googlebot kein Problem. Crawl Budget wird vor allem bei großen Websites mit mehreren Zehntausend oder Hunderttausenden URLs relevant, besonders wenn Filter, Parameter oder facettierte Navigation viele zusätzliche URLs erzeugen. Spätestens bei mehreren Hunderttausend crawlbaren URLs sollte die Crawl-Steuerung Teil der technischen SEO-Analyse sein.
Googlebot und KI: Crawling und Nutzung gezielt steuern
Mit AI Overviews, AI Mode und Gemini reicht es für SEOs nicht mehr aus, nur zu entscheiden, welche URLs der Googlebot crawlen darf. Zusätzlich stellt sich die Frage, für welche Google-Dienste die gecrawlten Inhalte verwendet werden dürfen.
Dabei solltest du Googlebot und Google-Extended getrennt betrachten. Der Googlebot crawlt Inhalte für die Google-Suche inklusive AI Overviews und KI-Modus. Seine Erreichbarkeit ist damit eine Voraussetzung dafür, dass Google Seiten und Änderungen verarbeiten kann.
Google-Extended ist dagegen kein eigener Crawler, sondern ein Token in der robots.txt. Damit steuerst du bestimmte Nutzungen der von Google gecrawlten Inhalte für Gemini. Eine Sperre von Google-Extended hat laut Google keinen Einfluss auf die Aufnahme oder das Ranking in der Google-Suche.
Möchtest du die organische Sichtbarkeit in Google erhalten, aber die Verwertung von Inhalten für Gemini ausschließen, kannst du deshalb Googlebot weiterhin crawlen lassen und Google-Extended separat sperren:
User-agent: Google-Extended
Disallow: /
Diese Trennung ist für die SEO-Planung entscheidend. Googlebot steuert den Zugriff für die Suche inklusive ihrer KI-Funktionen. Google-Extended steuert bestimmte zusätzliche Nutzungen für Gemini.
Mit nosnippet kannst du darüber hinaus verhindern, dass Google Text einer Seite als direkte Eingabe für AI Overviews und den AI Mode verwendet:
<meta name=“robots“ content=“nosnippet“>
Die URL kann weiterhin in Google erscheinen. Die Direktive beeinflusst aber zugleich die Darstellung in klassischen Suchergebnissen, weil Google dort keinen beschreibenden Textausschnitt aus der Seite anzeigen darf.
Mit max-snippet lässt sich die verwendbare Textmenge begrenzen. max-snippet:0 entspricht dabei nosnippet:
<meta name=“robots“ content=“max-snippet:0″>
Wenn du nur einzelne Inhalte ausschließen möchtest, ist data-nosnippet die gezieltere Variante:
<section data-nosnippet>
Dieser Bereich soll nicht verwendet werden.
</section>
Damit lassen sich bestimmte HTML-Bereiche von der Verwendung in AI Overviews und im KI-Modus ausschließen, während die übrigen Inhalte der Seite weiterhin berücksichtigt werden können. Strukturierte Daten wie JSON-LD werden durch data-nosnippet nicht ausgeschlossen.
Crawling nach dem SEO-Ziel planen
Für die technische Planung solltest du deshalb nicht pauschal „KI-Crawler erlauben oder sperren“ entscheiden. Ausgangspunkt ist die gewünschte Sichtbarkeit.
- Soll eine Seite in der klassischen Google-Suche, in AI Overviews und im AI Mode sichtbar sein, muss Googlebot auf die relevanten Inhalte zugreifen können und die Seite muss indexierbar sein.
- Soll die Search-Sichtbarkeit erhalten bleiben, die entsprechende Nutzung für Gemini aber ausgeschlossen werden, lässt du Googlebot zu und sperrst Google-Extended.
- Sollen einzelne Inhalte nicht für AI Overviews und den AI Mode verwendet werden, kommen
data-nosnippet,nosnippetodermax-snippetinfrage. Dabei musst du die Auswirkungen dieser Direktiven auf die klassische Suche berücksichtigen. - Soll eine Seite überhaupt nicht über die Google-Suche auffindbar sein, ist
noindexdie passende Maßnahme. Googlebot muss die Seite weiterhin crawlen können, damit Google diese Anweisung erkennt.
Für SEOs ergibt sich daraus eine klare Reihenfolge: Zuerst legst du fest, wo ein Inhalt sichtbar und verwendbar sein soll. Danach entscheidest du über Googlebot, Google-Extended und die Indexierungs- beziehungsweise Darstellungsregeln. Eine pauschale Sperre auf Crawler-Ebene ist dafür meist zu grob.
Googlebot mit Search Console und SISTRIX prüfen
Nach Änderungen an Crawling- und Indexierungsanweisungen solltest du prüfen, ob Google die gewünschten URLs weiterhin erreichen und verarbeiten kann. Für einzelne Seiten eignet sich dafür die URL-Prüfung der Google Search Console.
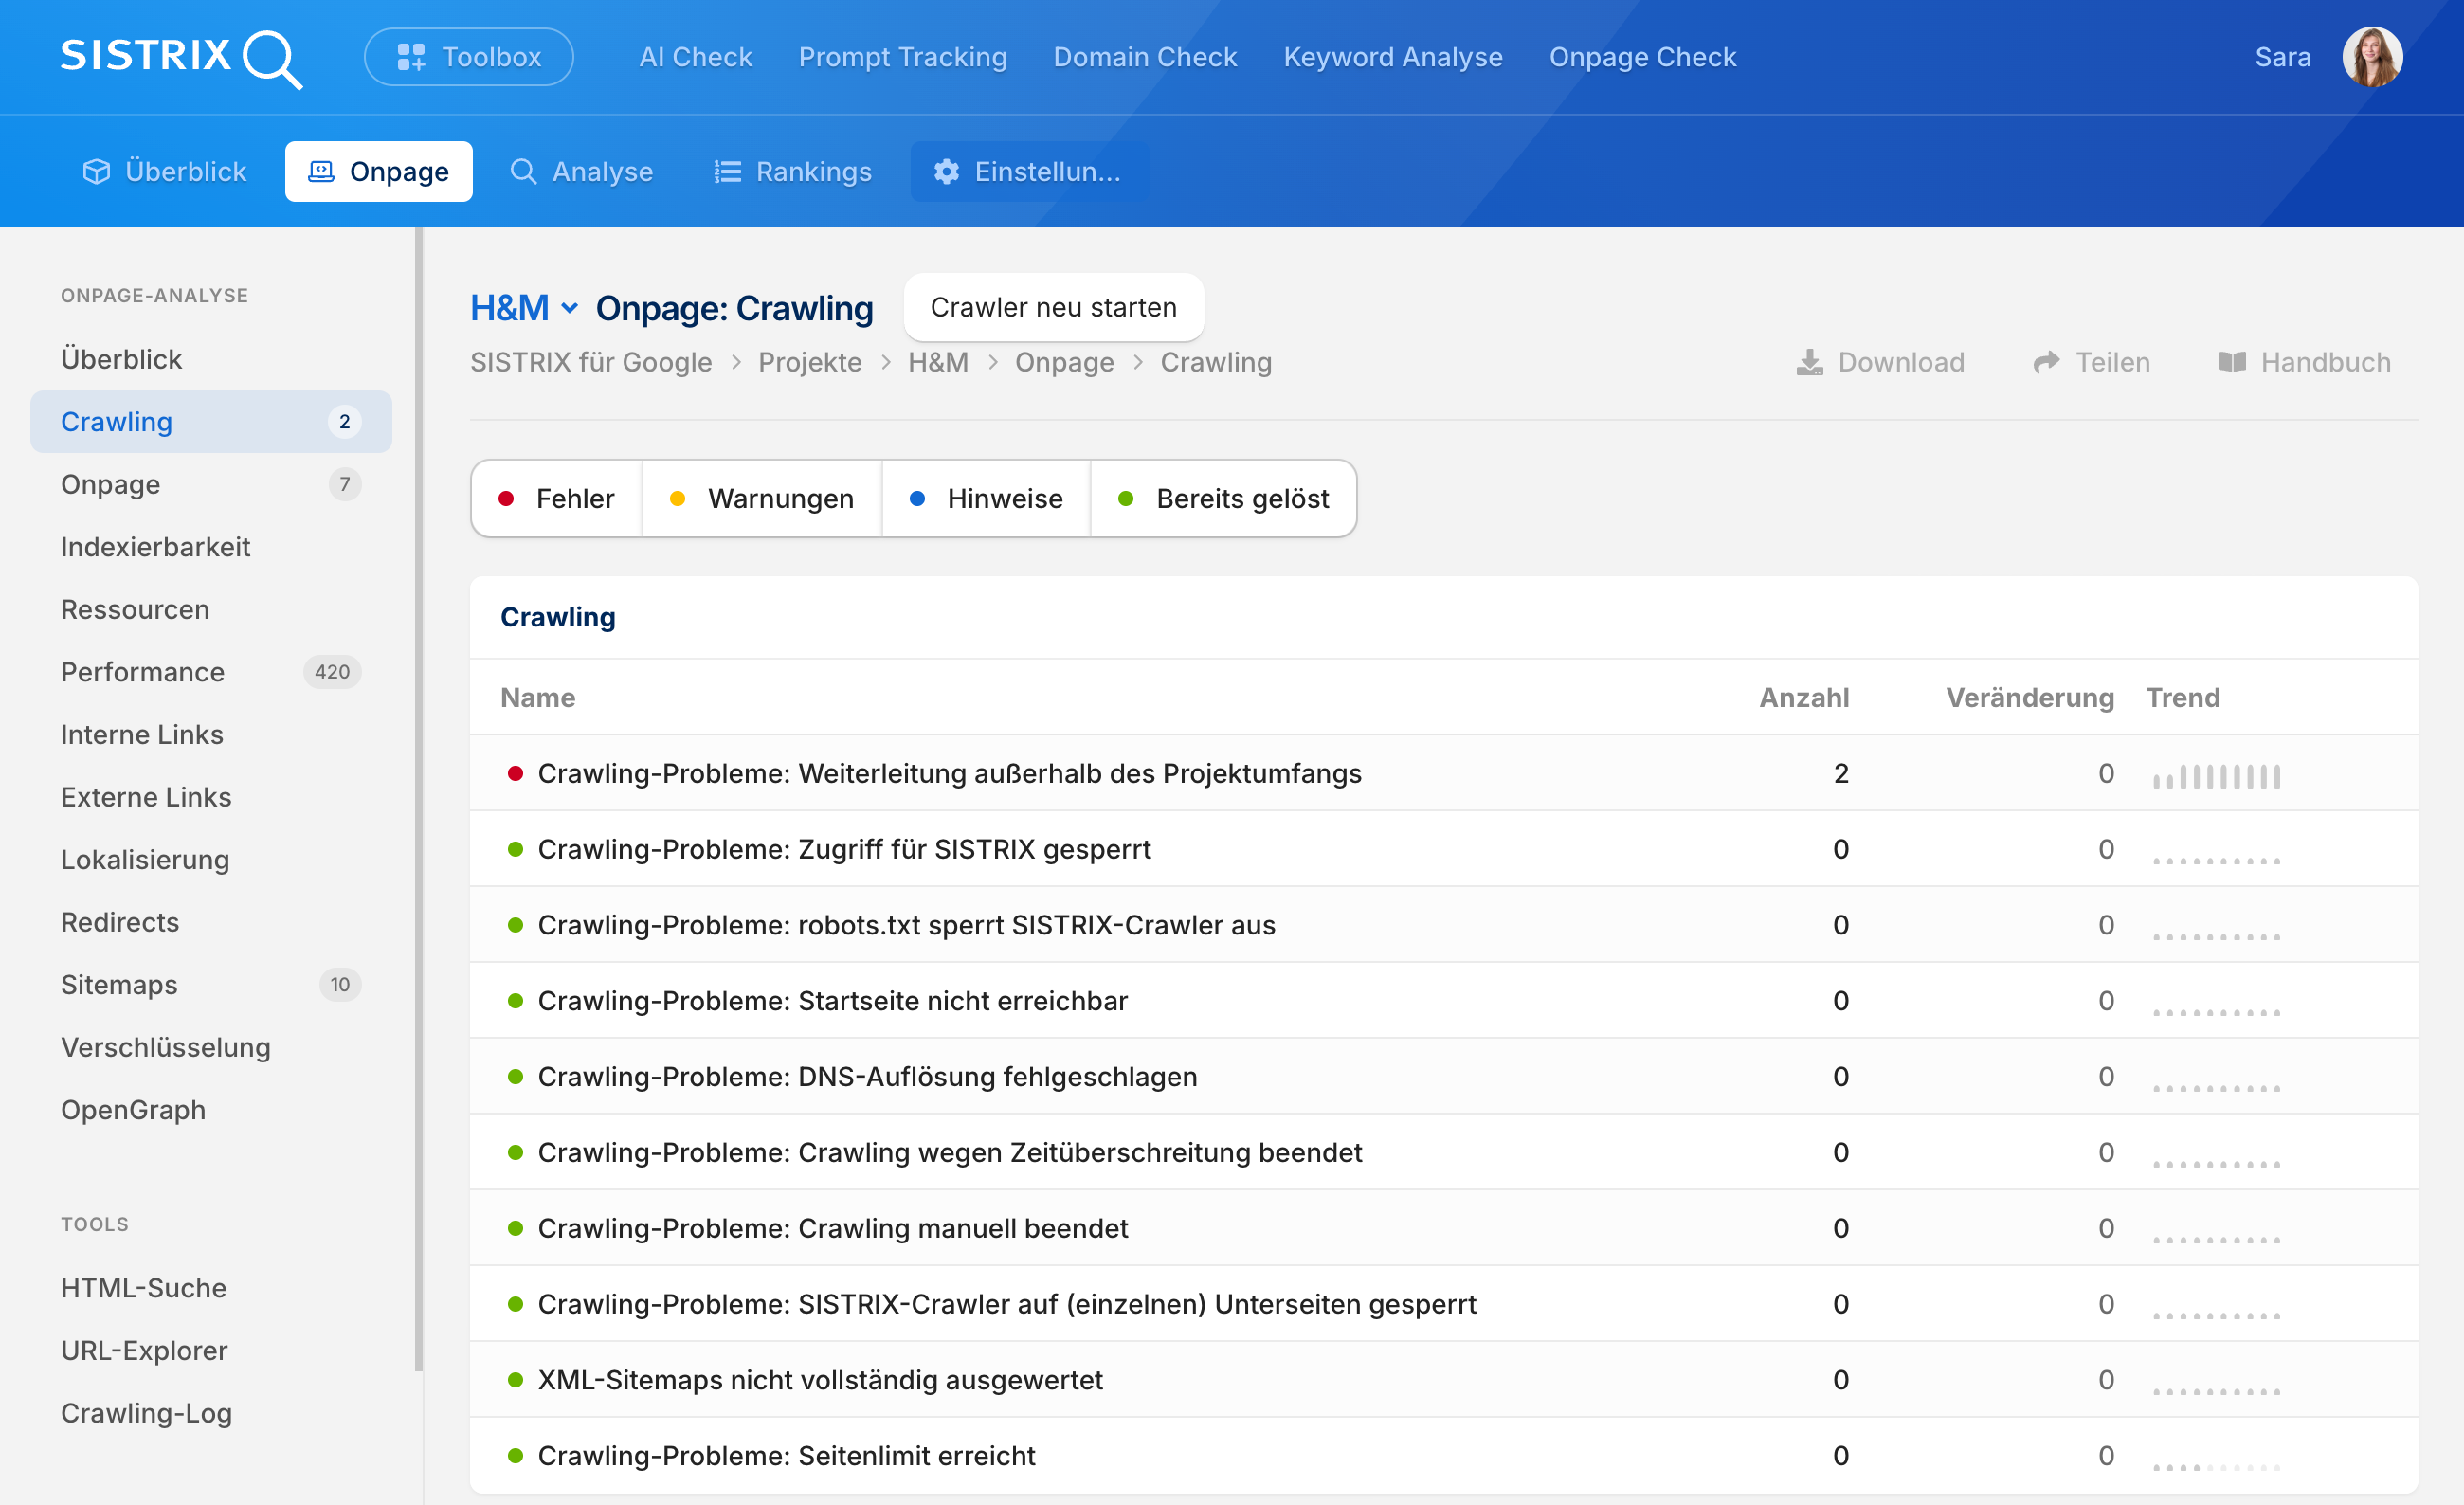
Bei größeren Websites hilft der SISTRIX Onpage-Crawler, technische Signale websiteweit zu kontrollieren. Dazu gehören robots.txt-Sperren, Meta-Robots-Anweisungen, Canonicals, HTTP-Statuscodes und die interne Verlinkung. So lassen sich auch widersprüchliche Signale erkennen, etwa eine intern stark verlinkte Landingpage mit noindex.
Nach der Umsetzung zeigt die Entwicklung von Rankings und Sichtbarkeit in SISTRIX, ob Google die gewünschten Seiten verarbeitet und die Änderungen den erwarteten Effekt auf die organische Suche haben.
Häufige Fehler bei der Steuerung des Googlebots
Besonders häufig treten diese Konfigurationsfehler auf:
Disallowwird verwendet, obwohl eine URL aus dem Google-Index entfernt werden soll.- Eine URL erhält
noindexund wird gleichzeitig für den Googlebot in der robots.txt blockiert. - CSS- oder JavaScript-Ressourcen werden gesperrt, obwohl Google sie zum Rendern benötigt.
- Vertrauliche Dateien werden lediglich über robots.txt ausgeschlossen.
- Ein
Disallow: /aus einer Entwicklungsumgebung gelangt auf die Live-Website. - Canonical wird als Ersatz für Crawling- oder Indexierungssteuerung behandelt.
Google-Extendedwird in der Erwartung blockiert, damit AI Overviews und den AI Mode abzuschalten.
Gerade globale Direktiven können große Teile einer Website gleichzeitig betreffen. robots.txt, Meta-Robots und Canonical-Regeln gehören deshalb nach Relaunches, Template-Änderungen und größeren technischen Releases in die SEO-Qualitätssicherung.
Häufige Fragen zum Googlebot
Googlebot arbeitet nicht nach einem festen Zeitplan. Wie häufig eine URL erneut gecrawlt wird, hängt unter anderem davon ab, wie häufig sich ihre Inhalte ändern, wie wichtig Google die URL für das Crawling einschätzt und wie schnell der Server auf Anfragen reagiert. Deshalb können einzelne Seiten einer Website sehr unterschiedlich häufig besucht werden.
Zugriffe von Googlebot lassen sich in den Server-Logfiles erkennen. Der dort angegebene User-Agent allein reicht allerdings nicht als Nachweis, da er von anderen Bots imitiert werden kann. Google beschreibt ein Verfahren über Reverse- und Forward-DNS-Lookups, mit dem sich echte Google-Crawler verifizieren lassen.
Google ruft die robots.txt regelmäßig ab und speichert sie normalerweise bis zu 24 Stunden im Cache. Eine Änderung muss deshalb nicht unmittelbar beim nächsten Crawl einer URL greifen. Bei Fehlern oder Problemen beim Abruf kann sich dieses Verhalten zusätzlich verändern.
Ja. Die Google Search Console stellt unter „Crawling-Statistiken“ Daten zu Googlebot-Anfragen bereit. Dort lassen sich unter anderem die Anzahl der Crawling-Anfragen, heruntergeladene Daten, Antwortzeiten und aufgetretene HTTP-Statuscodes untersuchen.
Google-Extended ist kein eigener Crawler und erzeugt deshalb keinen separaten Crawl durch einen „Google-Extended-Bot“. Das Token steuert bestimmte Verwendungen von Inhalten, die Google mit seinen bestehenden Crawlern abruft.
SISTRIX kostenlos testen
- Kostenloser Testaccount für 14 Tage
- Unverbindlich, keine Kündigung notwendig
- Persönliches Onboarding durch Experten


